L’actualité de la donnée de septembre 2026

Le 10 Octobre se tenait Open Lakehouse Day à Glasgow, un événement qui précède Community Over Code de la fondation Apache du 11 au 14. Nous nous faisions une joie d’y aller. Nous avons omis que l’Angleterre ne faisait plus partie de l’Union Européenne et qu’il fallait bien le passeport et le visa. Dommage. On s’en souviendra maintenant.

Le mois de septembre a connu nombre de conférences. C’est la reprise. Big Data Paris nous a un peu laissé sur notre fin. “Data et IA” à Nantes m’a réjoui : une belle énergie.  Des questions qui dépassent l’informatique, flirtant avec la philosophie. Des découvertes de projets open source français. Alors même que nous nous disons que les grands salons perdent de leur superbe face aux événements de grands acteurs du cloud, Big Data London, a semblé montrer – à distance – une dynamique loin de cet essoufflement que nous avons ressenti pour Big Data AI Paris.

Cette énergie perdue est bousculée par Meta qui sort Muse. Cette nouvelle application vient occuper la première place des meilleurs téléchargements des Apps Store ! Google, il y a quelques années avait sorti Google Now, un assistant qui avait pour vocation de nous aider dans toutes les tâches du quotidien. Et bien c’est Meta qui l’a fait ! Nombre d’organisations ont cherché comment monétiser l’IA. Meta semble avoir pris de court tout le monde.

Meta est aussi au centre des révélations de Mediapart. Peu d’entre nous connaissent le cyber forensics (ou l’analyse forensique numérique), une pratique qui consiste à identifier, collecter, préserver, analyser et présenter des preuves numériques issues d’appareils électroniques pour enquêter sur des cybercrimes ou des incidents de sécurité. Les commentateurs sont unanimes et détaillent la minutie avec laquelle les journalistes de Mediapart ont procédé à leurs investigations. Il eut été intéressant d’avoir le point de vue des meilleurs analystes de l’ANSSI.

L’IA de Meta fait aussi le lien sur les déconvenues d’Oracle pour la construction des data centers… D’aucun y voit les signes de l’éclatement de la bulle.

Il n’est sans doute pas évident de se frayer un chemin dans ce dédale informationnel. Vous devez pourtant choisir vos architectures, convaincre vos directions du bien fondé de celles que vous montez. Synaltic a fait le choix de comprendre ces articulations afin de pouvoir l’expliquer et vous accompagner pour bâtir vos data / AI platform. La souveraineté n’est pas un vain mot. La souveraineté se gagne aussi par les données.


Data AI Sovereignty Summit 2027


La souveraineté se construit sur le terrain. Partagez votre expérience !

Vous avez conduit un projet Data, IA ou Cloud, fait évoluer une architecture ou engagé une démarche pour mieux maîtriser vos dépendances technologiques ? Contribuez au programme du Data AI Sovereignty Summit Paris 2027, le 25 février 2027 au Pathé Palace, à Paris.

Construit par les end users, pour les end users, le DAISS donne la parole à celles et ceux qui décident, déploient et gouvernent les solutions dans leurs organisations.

Partagez votre expérience et contribuez au programme !


Projets Data augmentés par l’IA

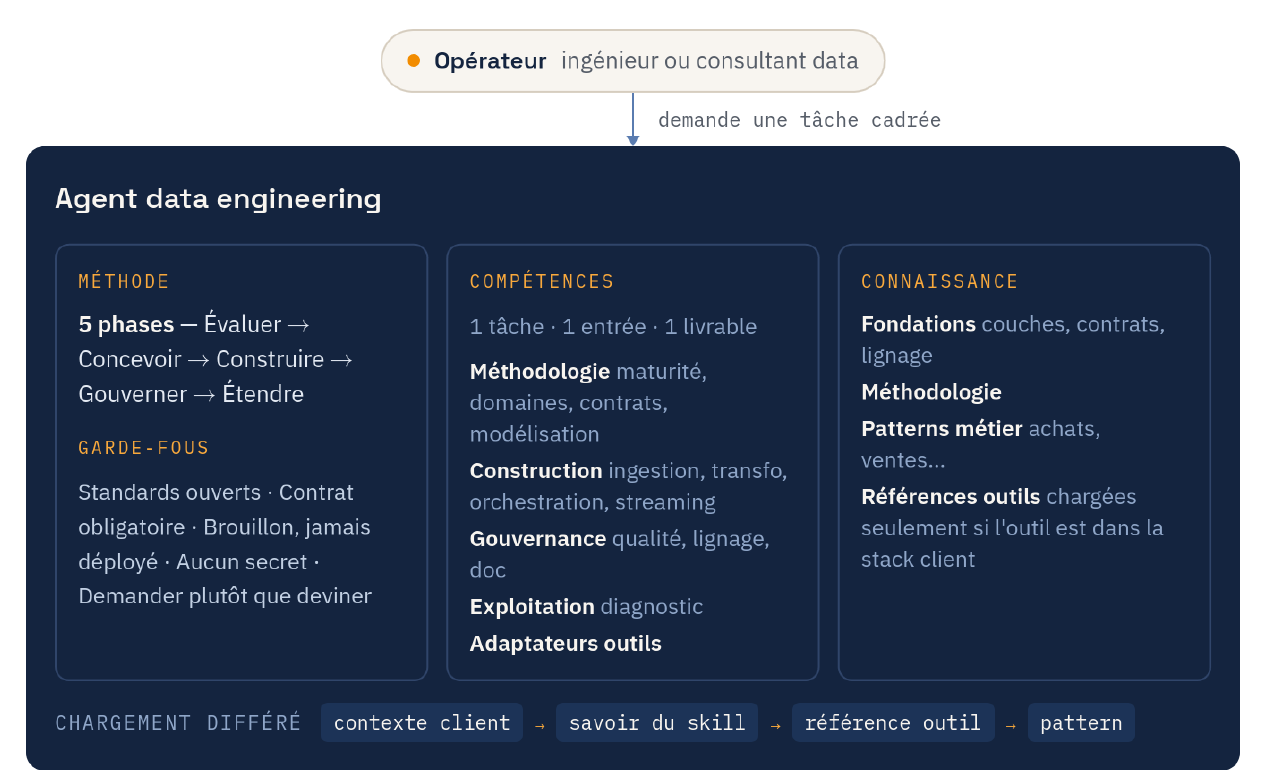
Voilà bientôt un an que nous repensons jour après jour, la manière dont nous travaillons au quotidien nos projets de données à l’aune de l’IA. Comme tout le monde, nous avons exploité la fenêtre conversationnelle. Nous y avons vite trouvé des limites. D’abord dans la collaboration, ensuite dans le partage du contexte, de la mémoire des agents de développement. Et tout le monde est unanime : l’accès à la donnée ne suffit pas à l’agent pour construire des analyses pertinentes et cohérentes.

C’est pourquoi nous avons bâti nos agents pour aider chaque consultant dans la réalisation de chacune de ses tâches.

Tout va si vite que ce sont nos clients qui nous demandent, maintenant, de les accompagner à mettre en place leurs projets data augmenté par l’IA.


Souveraineté par les données : architecture multi-moteurs gagne du terrain

Cette lettre est la preuve même de notre investissement dans la compréhension des architectures de données. Nous ne nous arrêtons pas à la technique. Nous partageons une vision à 360° de ce qu’est un projet. Comment est-ce que vous devrez le démarrer. Comment est-ce qu’il va grandir. Qui a mis en place quoi pour parvenir à décentraliser sa plateforme.

Data Mesh, j’y crois encore. En 2012, nous vendions déjà ce concept à la Croix Rouge française. Une plateforme unique MySQL Column Store, Talend, Tableau. Des domaines séparés, des jeux de données centraux et communs. On ne parlait pas de data product ! Le projet a trouvé son rythme. Les différentes divisions de la CRf ont été servies. La stack répond toujours !

Aujourd’hui, Gartner indique que Data Mesh n’atteindra pas le plateau… Le projet de la CRf tel qu’il a été imaginé dès le départ a permis qu’il dure encore aujourd’hui, y compris sans Synaltic.

Notre ambition dépasse vos attentes immédiates. Nous reconnaissons que nous devons bien valider les premiers jalons. Nous savons aussi qu’il nous faut vous aider à voir plus loin.

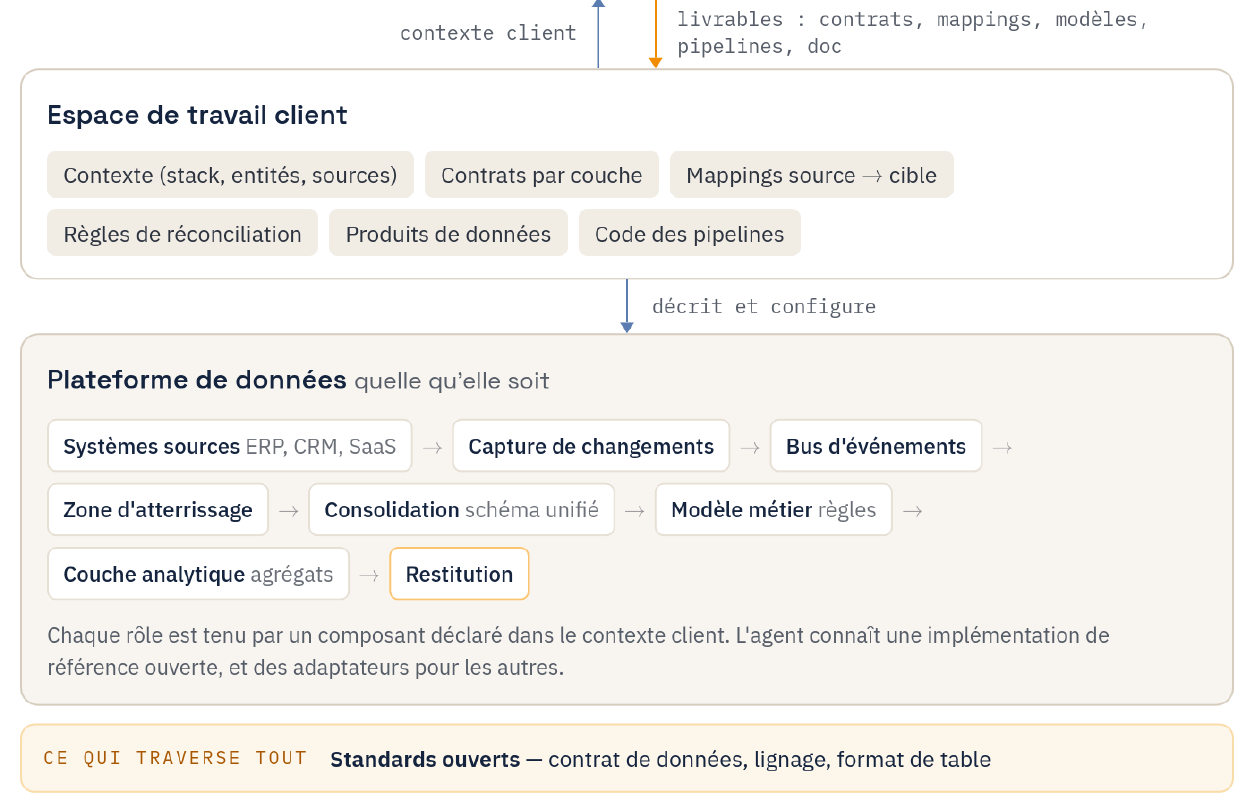
Comment vous expliquer dès lors que la donnée doit être au centre. Que le moteur d’aujourd’hui ne sera pas le moteur de demain. Ou autrement : le moteur de production des données n’est pas celui de la transformation, ni celui de la diffusion.

Nous rentrons maintenant dans une ère où votre plateforme de données intègre naturellement plusieurs moteurs afin de coller au mieux à vos attentes.


Interopérabilité à tous les étages : fini l’enfermement ?
Pourquoi autant d’éditeurs cherchent tellement à ne plus nous enfermer ? Apache Iceberg™ est un exemple. Combien d’éditeurs s’efforcent de rendre leur moteur des plus performant au dessus d’un format ouvert ? Etonnant ! Non ? Sont-ils devenus tous écolos ? Est-ce que ça coûte trop cher de déplacer des données ? Ho c’est sûr ! Et bien tout le monde s’est dit que le catalogue devenait le nouveau moyen de vous garder “locké”.

On dirait que ça ne va pas non plus se passer comme ça. Même sur le catalogue la recherche de l’interopérabilité reste le cap. Tout comme pour l’IA, ce n’est ni le format, ni le catalogue qui constituent la différenciation. Ce n’est pas le modèle qui fait tout. Mais bien le harnais.

Votre plateforme de données vous offre toutes ces petites choses qui facilitent votre quotidien. Votre principal actif s’incarne par vos données, leur qualité, leur accès.


Pour compléter votre LECTURE :


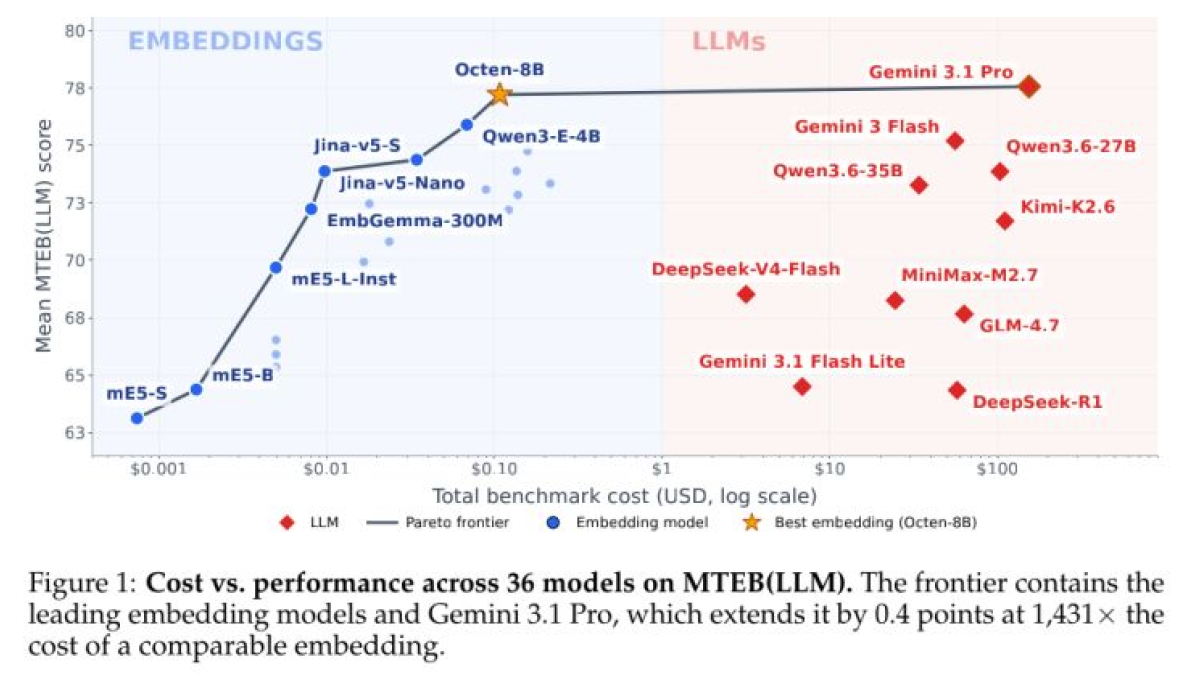
Peut-on remplacer les modèles d’embedding par des LLM généralistes ? Une étude de 2026, comparant 10 LLM et 26 encodeurs sur 37 tâches, observe seulement 0,4 point d’écart, pour un coût jusqu’à 1 431 fois supérieur.


Dans « How AI Agents Are Restructuring the Software Paradigm« , l’auteur défend l’idée que les agents ne changent pas seulement notre façon de coder : ils redéfinissent ce qu’est un logiciel. L’agent génère son code à la volée, l’exécute, puis le jette. Notre rôle passerait ainsi d’« auteur de code » à « architecte d’intention ».

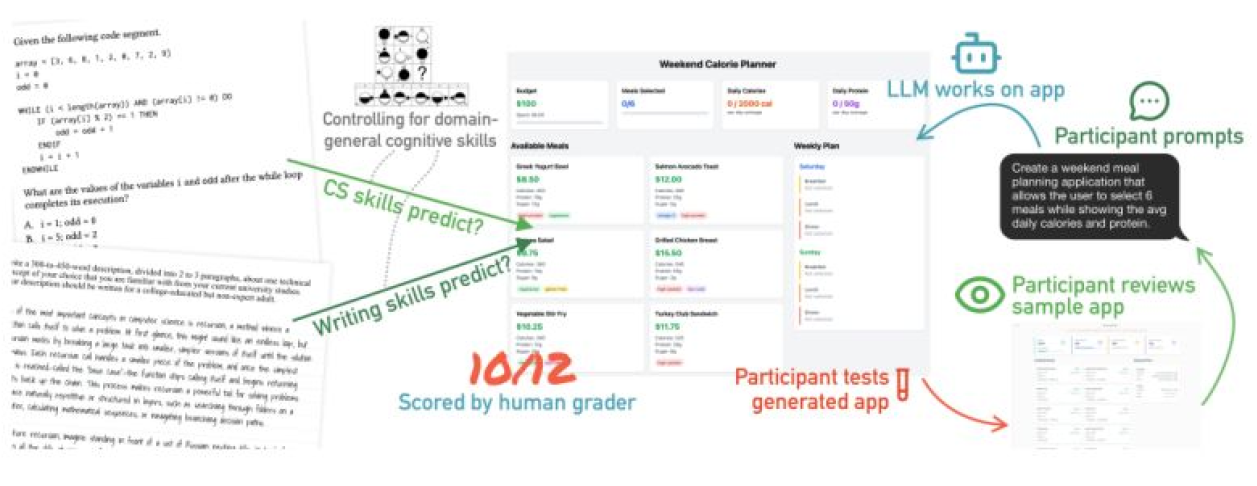
Cette étude menée auprès de 100 étudiants montre que les compétences en informatique et en communication écrite prédisent significativement la performance en vibe coding. Les compétences informatiques restent le principal facteur prédictif : l’IA transforme le développement logiciel, mais n’en remplace pas les fondamentaux.


MISE À JOUR
Mise à jour de septembre 2026 


Dbt 2.0

 dbt 2.0 introduit un moteur unique en Rust, des performances nettement améliorées, dbt State en GA et Lake Compute en bêta pour exécuter SQL directement sur Iceberg.


Apache Iceberg™ 1.12

 Iceberg 1.12 apporte des améliorations majeures sur les manifest lists, renforce la compatibilité des catalogues et introduit plusieurs corrections critiques pour la stabilité des tables.


Apache Polaris™ 1.8.0

 Polaris 1.8.0 ajoute l’autorisation dédiée pour les semantic models, sécurise les commits concurrents, rend le schéma JDBC configurable et introduit plusieurs étapes d’upgrade manuelles.


Talend + AI augmented

 Talend Cloud introduit l’ingénierie agentique : pipelines déclaratifs en YAML, agents dédiés (qualité, produits, glossaire) et intégration native des LLM dans les workflows data.


Duckle v0.7.4

 Duckle v0.7.4 améliore la stabilité du moteur de flux, corrige plusieurs erreurs de parsing et introduit des optimisations sur la gestion des pipelines asynchrones.


Kestra 2.0

 Kestra 2.0 réécrit entièrement son moteur, sépare contrôle et données, expose chaque flow comme outil MCP, ajoute un éditeur visuel, un Copilot intelligent et un modèle d’orchestration conçu pour l’ère des agents.


Effect 4.0

 Effect 4.0 introduit un nouveau runtime plus rapide, un système de scheduling repensé, des améliorations majeures sur les fibres et une API plus cohérente pour la programmation fonctionnelle.


Apache Datafusion Comet 1.1.0

 Comet 1.1.0 améliore l’optimisation vectorisée, étend le support des fonctions SQL, renforce la stabilité du moteur Rust et corrige plusieurs régressions introduites en 1.0.0.